
把武汉理工的 "DeepSeek云服务版"包装成标准协议接口,让 pi、Claude Code、Codex CLI、Cline、Cherry Studio 或任何 OpenAI SDK 都能直接用上学校的模型。
这套 OpenWebUI 本来就提供 OpenAI 格式的接口(POST /api/chat/completions),所以不需要逆向网页、不需要浏览器自动化。
真正麻烦的只有两个:
- 个人 API Key 被管理员关了(
enable_api_key: false)→ 只能用浏览器登录后那份 JWT; - 这份 JWT 7 天过期,而且是一大串
eyJhbGciOi...——直接塞进各个 AI 工具,每 7 天要改一遍配置,还没法统一做参数修正。
于是有了这层本地代理:把「凭证」和「协议修正」从每个客户端里收出来,集中在一处处理。
| 步骤 | 发生了什么 |
|---|---|
| ① | 客户端用本地假 key(sk-whut-local)请求 http://127.0.0.1:8787/v1/... |
| ② | 代理注入真实的学校 JWT(从 data/token 读,按修改时间热加载,换 token 不用重启) |
| ③ | 代理修正参数:max_completion_tokens → max_tokens、钳制输出上限、剔除 store/metadata 等上游不认识的字段 |
| ④ | 转发到 https://chatcloud.whut.edu.cn/api/chat/completions,再转给 DeepSeek |
| ⑤ | 响应字节级透传回来(流式不拆包、不重组),同时把 usage / 耗时落库到 data/usage.db(SQLite) |
| ⑥ | 客户端拿到的就是标准响应:OpenAI JSON / SSE、Anthropic 事件流或 Responses 事件流,工具调用原样可用 |
| 入口 | 给谁用 | 说明 |
|---|---|---|
POST /v1/chat/completions |
pi · Cline · Cherry · Continue · OpenAI SDK | 原生支持 tools / tool_calls,流式增量 |
POST /v1/messages |
Claude Code · Anthropic SDK | 把 OpenAI delta 翻译成 Anthropic 事件序列,含 thinking 块与 count_tokens |
POST /v1/responses |
Codex CLI(0.1xx 起只支持 Responses API) | 输出 output 数组 + 事件流,兼容 wire_api = "responses" |
三个入口共用同一个 provider,所以限速、熔断、重试、用量统计、分发 key 全都一致。
动画图中间的四个模块:
| 模块 | 作用 | 关键实现 |
|---|---|---|
| ① 转发 proxy | 协议转换 + 参数修正 | max_tokens 归一与钳制、字段白名单剔除、SSE 透传 |
| ② 续期 auth | token 永不手动维护 | 启动时 + 每 60 分钟检查,剩余 < 2 天自动换;被 401/403 时当场换并重试原请求 |
| ③ 统计 usage | 知道用了多少 | SQLite 落库(重启不清零),按模型 / 按 key / 按小时聚合,CSV 导出 |
| ④ 分发 access | 多设备各用各的 | 独立 key、每分钟限速、每日 token 配额、随时吊销,用量分开统计 |
实测(2026-11):学校的 POST /api/v1/auths/signin 只校验学号是否存在,password 字段只要非空即可通过。
所以本项目只需要学号,从不保存也不需要你的密码。
共同前提:必须能访问校园网(校内 / 学校 VPN)。校外直连会超时。 若本机开着 Clash / Surge 等代理,请把
whut.edu.cn加进直连规则——学校会拒绝代理节点的出口 IP。
懒人方案:把下面这段话直接发给你自己的 AI agent(pi / Claude Code / Cline 都行),让它替你装:
帮我在本机安装并部署 https://github.com/Song-xuan-xuan/wut-deepseek2api 这个项目:
1. git clone 到当前目录,用 python3 -m venv .venv 建虚拟环境,安装 requirements.txt
2. 复制 config.example.json 为 config.json
3. 后台启动 .venv/bin/python -m app(macOS/Linux),或 .venv\Scripts\python -m app(Windows)
4. 确认 http://127.0.0.1:8787/health 返回 200,并把面板地址 http://127.0.0.1:8787/dashboard 告诉我
5. 提醒我在面板「认证」页填学号完成认证(不需要密码)
6. 如果端口 8787 被占用、依赖装不上、或代理导致连不上学校,请自行排查并汇报原因
注意:必须先能访问校园网;token 和数据库都保存在项目内的 data/ 目录。
适合:想改代码、调面板,或机器上不方便跑 Docker。
① 准备环境
| 依赖 | 版本 | 检查 |
|---|---|---|
| Python | 3.10+ | python3 --version |
| Node.js(可选) | 18+ | 只有改前端面板才需要 |
② 拉代码并启动
git clone https://github.com/Song-xuan-xuan/wut-deepseek2api.git
cd wut-deepseek2api

python3 -m venv .venv
.venv/bin/pip install -r requirements.txt          # Windows: .venv\Scripts\pip install -r requirements.txt
cp config.example.json config.json                 # Windows: copy config.example.json config.json
.venv/bin/python -m app                            # Windows: .venv\Scripts\python -m app
③ 一键认证
打开 http://127.0.0.1:8787/dashboard → 左侧「认证」→ 输入学号 → 点「认证」。
看到"认证成功,token 剩 7.0 天"就好了:学号写回 config.json,token 写到 data/token,
之后每 60 分钟检查、剩余不足 2 天自动续期——再也不用管 token。
不装 Python,只要 docker + docker compose:
git clone https://github.com/Song-xuan-xuan/wut-deepseek2api.git
cd wut-deepseek2api

cp .env.example .env        # 填 WHUT_EMAIL=你的学号(也可以先本地认证一次,凭证落在 ./data/token)
docker compose up -d --build
docker compose logs -f # 看到 "token 7.0 天后过期" 就成功了验证:curl --noproxy '*' -s 127.0.0.1:8787/health,然后打开 http://127.0.0.1:8787/dashboard。
数据都在 ./data(token + usage.db),删容器不丢。
容器流量会跟着宿主机的系统代理走,而学校会拒绝代理节点的出口 IP。
症状很好认:宿主机 curl 返回 200,容器里 TLS 握手却被重置 / /health 报 ConnectError。
解决办法:在代理规则里让学校域名直连。以 FlClash 为例,四步:
-
打开 FlClash → 左侧 配置(Profiles) → 找到你在用的那份 → 点右侧 编辑(Edit / 编辑文件)
-
找到
rules:这一段,把下面两行加到最前面(缩进与rules:同级,两个空格起头):rules: - DOMAIN-SUFFIX,whut.edu.cn,DIRECT - IP-CIDR,218.197.110.99/32,DIRECT,no-resolve # ↓ 以下是原本就有的规则,保持不动 - DOMAIN-SUFFIX,google.com,Proxy ...
-
保存(
⌘S/ 右下角保存),FlClash 会自动重载配置;没重载就点一下该配置重新应用 -
验证——这条命令输出
200就通了:docker compose exec whut-2api python -c \ "import urllib.request;print(urllib.request.urlopen('https://chatcloud.whut.edu.cn/api/config',timeout=10).status)"
如果还是超时/报错,再补一条(有些订阅会把 IP 直连写死):
- AND,((DOMAIN-SUFFIX,whut.edu.cn),(NETWORK,tcp)),DIRECT
所有客户端都是同一组值(面板「仪表盘」页可一键复制,或「分发 / Key」页下载现成模板):
| 项 | 值 |
|---|---|
| Base URL | http://127.0.0.1:8787/v1 |
| API Key | sk-whut-local(config.json 的 client_api_key) |
| 模型 | deepseek-v4-flash |
pi(`~/.pi/agent/models.json`)
{
  "whut": {
    "baseUrl": "http://127.0.0.1:8787/v1",
    "api": "openai-completions",
    "apiKey": "sk-whut-local",
    "models": [
      {
        "id": "deepseek-v4-flash",
        "name": "WHUT DeepSeek V4 Flash",
        "contextWindow": 700000,
        "maxTokens": 120000,
        "input": ["text", "image"],
        "reasoning": false,
        "compat": {
          "supportsStore": false,
          "supportsDeveloperRole": false,
          "supportsReasoningEffort": false,
          "maxTokensField": "max_tokens",
          "supportsStrictMode": false
        }
      }
    ]
  }
}
pi --model whut/deepseek-v4-flashClaude Code(走 `/v1/messages`)
# 方式一:临时覆盖,不影响已有的 ~/.claude/settings.json
export ANTHROPIC_BASE_URL="http://127.0.0.1:8787"
export ANTHROPIC_AUTH_TOKEN="sk-whut-local"
export ANTHROPIC_MODEL="deepseek-v4-flash"
export ANTHROPIC_SMALL_FAST_MODEL="deepseek-v4-flash"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=700000
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1

claude -p "只回复两个字:成功"
方式二:把「分发 / Key」页生成的 claude-code 模板存成 ~/.claude/whut.json,
然后 claude --settings ~/.claude/whut.json(推荐,避免和已有配置冲突)。
Codex CLI(走 `/v1/responses`)
~/.codex/config.toml:
model = "deepseek-v4-flash"
model_provider = "whut"

[model_providers.whut]
name = "WHUT OpenWebUI"
base_url = "http://127.0.0.1:8787/v1"
env_key = "WHUT_API_KEY"
wire_api = "responses"
request_max_retries = 2
stream_max_retries = 1
export WHUT_API_KEY=sk-whut-local
codexCherry Studio / Chatbox
设置 → 模型服务 → 添加 → OpenAI,填上表三项,模型名手填 deepseek-v4-flash。
Cline / Roo Code(VS Code)
Provider 选 OpenAI Compatible,填 Base URL / Key / Model ID,勾选 "Supports Tools"。
Continue(`~/.continue/config.json`)
{
  "models": [
    {
      "title": "WHUT DeepSeek",
      "provider": "openai",
      "model": "deepseek-v4-flash",
      "apiBase": "http://127.0.0.1:8787/v1",
      "apiKey": "sk-whut-local"
    }
  ]
}
命令行 / Python SDK
# OpenAI 协议
curl --noproxy '*' -s 127.0.0.1:8787/v1/chat/completions \
  -H "Authorization: Bearer sk-whut-local" -H 'Content-Type: application/json' \
  -d '{"model":"deepseek-v4-flash","messages":[{"role":"user","content":"你好"}],"max_tokens":512}'

# Anthropic 协议
curl --noproxy '*' -s 127.0.0.1:8787/v1/messages \
  -H "x-api-key: sk-whut-local" -H "anthropic-version: 2023-06-01" \
  -H 'Content-Type: application/json' \
  -d '{"model":"deepseek-v4-flash","max_tokens":256,"messages":[{"role":"user","content":"你好"}]}'
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8787/v1", api_key="sk-whut-local")
resp = client.chat.completions.create(
model="deepseek-v4-flash",
messages=[{"role": "user", "content": "你好"}],
max_tokens=512,
)
print(resp.choices[0].message.content)统计写在 data/usage.db(SQLite)。如果这个文件被写坏,代理会自动把它改名留档
(usage.db.corrupt-<时间戳>)并重建空库,同时 /health 的 warnings 和面板「系统信息」
都会显示提示 —— 不会再出现「面板一直是 0 却毫无提示」的情况。
常见成因都是「同一时刻有多个进程写同一个库」:
- 本地源码和 Docker 容器同时在跑(
docker compose ps和lsof -ti:8787都查一下,只留一个) - 容器
--force-recreate/down时正好有请求在写 - 直接在宿主机用别的工具打开
data/usage.db又强行中断
处理:
docker compose stop
mv data/usage.db.corrupt-* /tmp/         # 想留证据就备份到别处
docker compose up -d # 会新建一个干净的库学校这套 OpenWebUI 的失败模式比较杂,代理层统一兜住,客户端不需要自己重试:
| 上游返回 | 代理怎么处理 |
|---|---|
429 / 502 / 503 / 504 |
传输层自动重试(upstream.retries,默认 2 次,指数退避) |
401 / 403 |
先用学号续期 token 再重试;续期失败也会再试一次(学校 WAF 偶发 403) |
400 且消息像抖动(Server Connection Error / Open WebUI: / timeout / overloaded …) |
重试(upstream.transient_retries,默认 3 次) |
400 且是真·参数错误(Model not found、max_tokens too large …) |
不重试,直接返回,省上游时间 |
400 但消息以 429 开头(学校把限流包成 400) |
还原成 429 rate_limit_error,并计入模型健康看门狗 |
重试只发生在「拿到响应头之前」,对流式请求同样安全;每次重试都会在日志里留一行:
[19:58:02] chat 重试 1/3(400 'Open WebUI: Server Connection Error')
[19:58:02] chat 重试 2/3(400 'Open WebUI: Server Connection Error')
实测:上游连续两次 400 抖动 → 客户端拿到正常结果;一直 403 → 1 + 3 次尝试后(约 2.4 s) 返回带续期提示的 403,不会无限重试。
所有请求都会落库到 data/usage.db(SQLite),重启不清零,面板可按区间/模型/Key 查看,也能导出 CSV。
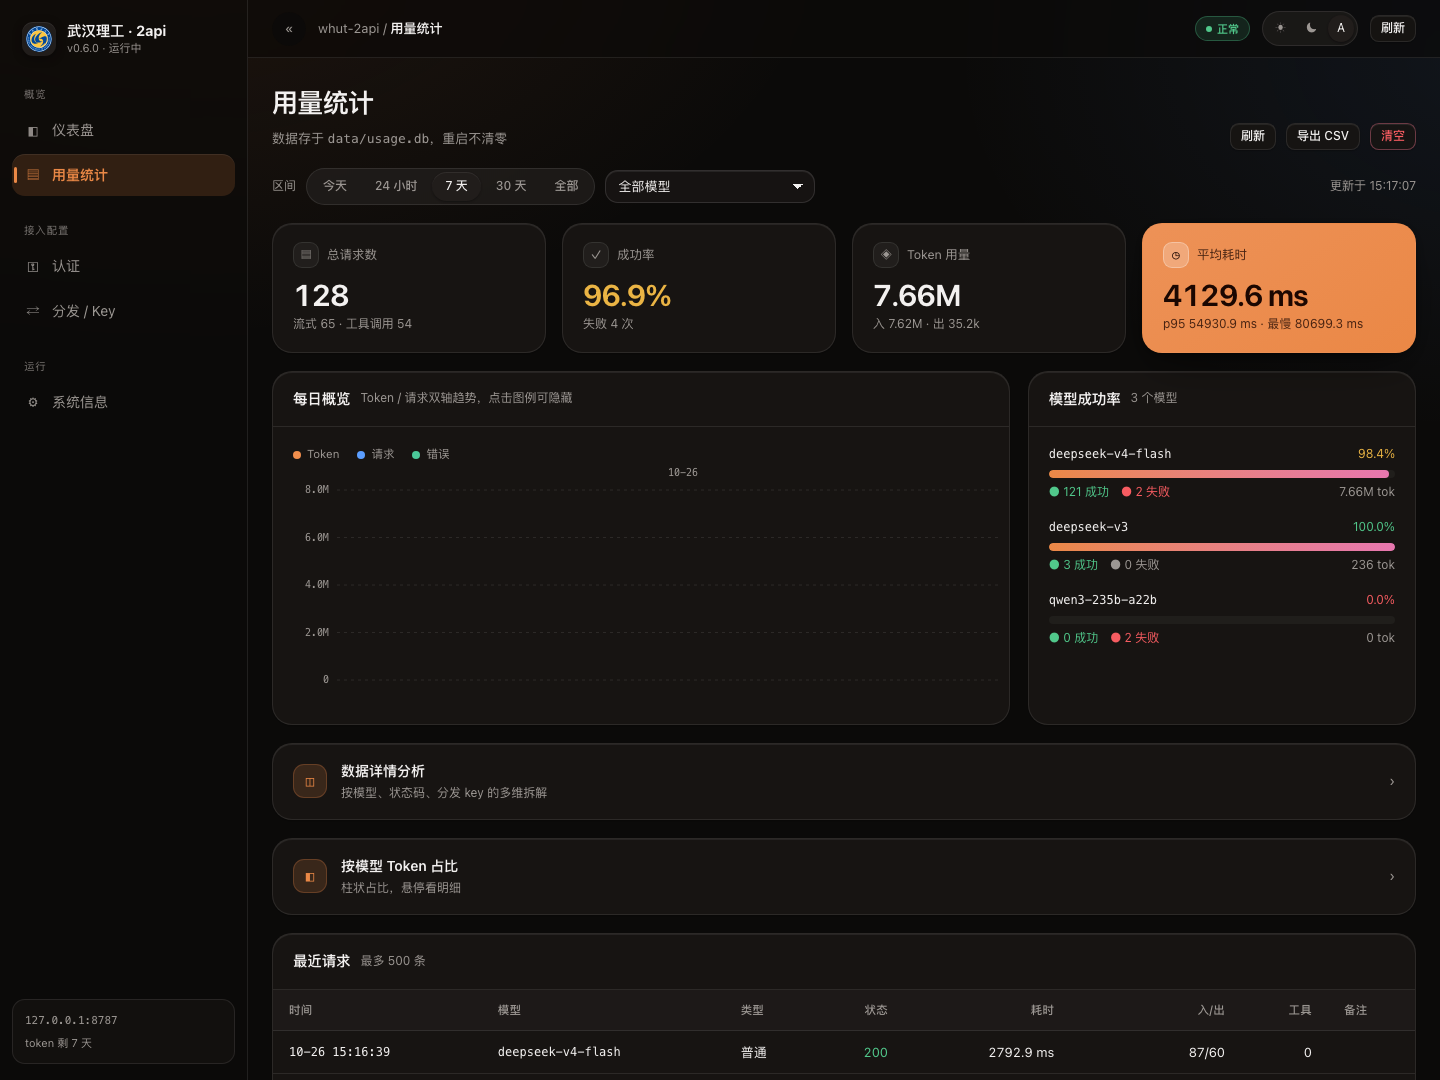
学校三个模型的真实表现(2026-10-26 实测,真实打到上游,不是抄官方参数):
| 模型 | 对话 | 流式 | 首字 TTFT | 生成速度 | 工具调用 | 上下文 | 图片 | 并发 | 定位 |
|---|---|---|---|---|---|---|---|---|---|
deepseek-v4-flash |
✅ | ✅ | ≈ 2.5 s | ≈ 27 tok/s | ✅ | ≥ 745,080 tokens | ❌ | 1/2/4/6 全部零失败 | 主力 |
deepseek-v3 |
✅ | ✅ | ≈ 7.4 s(慢 3 倍) | ≈ 15 tok/s | ⚠️ auto 可以,required 失效 |
≥ 37,535 tokens(1 MiB 内封顶) | ❌ | 1/2/4/6 全部零失败 | 备用(慢但稳) |
qwen3-235b-a22b |
❌ | — | — | — | — | — | — | — | 上游 429,不可用 |
更详细的测评请看 👉 docs/model-capabilities.md
| 约束 | 实测值 | 对你的影响 |
|---|---|---|
| 请求体上限 | 1,048,576 字节(1 MiB),超了 nginx 直接 413 |
折合 17~80 万 token,取决于内容密度 → 详见下一节 |
| 输出预算 | 简单问答 ≥ 512,多轮与 agent 单步 ≥ 1024,工具/推理 ≥ 2048 | flash 的思维链占输出 token 的 68%,给少了会得到「200 + 空正文」,看着像模型坏了 |
tool_choice |
一律用 auto |
required 不可靠:上游把工具调用写成 content 里的 <|DSML|invoke …> 标记,tool_calls 却是 null |
这是本项目**最容易误解、也最容易误判成「代理有 bug」**的地方,所以单独讲清楚。
模型能读 74 万 token,但学校 nginx 只允许一次请求 1 MiB 字节。 这两件事用不同的单位度量,1 MiB 折合多少 token 取决于你的内容类型 —— 所以「模型窗口 1M tokens」和「传输上限 1 MB」完全不是同一件事,只是数字看起来像。
客户端每轮的请求体(全部历史 + system + 工具 schema,每轮全量重发,不是增量)
    │
    ├─ ① nginx  client_max_body_size 1m  →  1,048,576 字节   硬上限,超了立刻 413
    │                                       (请求根本没到模型)
    ├─ ② OpenWebUI  RAG_FILE_MAX_SIZE    →  2 MB             上传文件时才检查
    │                                       (永远轮不到它生效)
    └─ ③ 模型窗口                         →  ≥ 745,080 tokens 只有前两道没超才受它约束
生效顺序永远是「最紧的那道先拦」:① > ② > ③,所以实际可用上下文 = min(① ÷ 每token字节数, ③)。
| 数值 | 单位 | 管什么 | 谁在管 | 超了会怎样 | |
|---|---|---|---|---|---|
| 请求体上限 | 1,048,576 | 字节 byte(1 MiB = 1024×1024) | 一次 HTTP 请求的 body 有多大 | 学校 nginx 1.27.4 | 17~33 ms 内返回 413(nginx 的 HTML 页),请求根本没到模型 |
| 模型窗口 | ≥ 745,080 | token | 模型一次能读多少内容 | DeepSeek 模型 | 报错或静默截断 |
| 上传文件上限 | 2 | MB(应用设置) | 知识库/附件文件多大 | OpenWebUI RAG_FILE_MAX_SIZE |
实际永远轮不到(见下) |
补充两点常被忽略的:
- 只算 body,HTTP 头不算;
Content-Length与Transfer-Encoding: chunked都按总量计。 - 是「每次请求」而不是「整个会话」:agent 每轮都把历史重发一遍,所以会话越长越接近这条线。
同一个 1 MiB,装多少 token 完全看内容(全部为本项目实测):
| 内容类型 | 每 token 字节数 | 1 MiB 折合 | 依据 |
|---|---|---|---|
高熵随机 ASCII(aK#9$mQ…,测窗口时用) |
≈ 1.3 | ≈ 80 万 tokens | 974,025 字符 → body 0.95 MiB → prompt_tokens = 745,080 |
| 重复数字 | ≈ 3.0 | ≈ 35 万 tokens | 1 MiB body → prompt_tokens = 349,578 |
| 代码 / agent 会话 | ≈ 4.0 | ≈ 26 万 tokens | 7.24 MB / 1624 条消息实测 |
| 英文散文 | ≈ 5.0 | ≈ 21 万 tokens | 1 字节/字符 ÷ 0.20 token/字符 |
| 中文 | ≈ 6.1 | ≈ 17 万 tokens | 3 字节/字符 ÷ 0.49 token/字符 |
换句话说:中文内容到 17 万 token 就撞墙了,而随机串能装 80 万 —— 差 4 倍以上,但都发生在同一个 1 MiB 上。
用不存在的 model 名探测,让上游几毫秒内回 400,这样每次只测 nginx 那一层:
| 请求体大小 | 结果 | 耗时 | 说明 |
|---|---|---|---|
| 1,048,000 B | 400 |
128 ms | 通过 nginx(被上游拒:model 不存在) |
| 1,048,576 B | 400 |
140 ms | 通过 —— 正好卡在上限 |
| 1,048,577 B | 413 |
17 ms | 被拒 —— 多 1 字节就死 |
| 1,100,000 B | 413 |
33 ms | 被拒 |
用真实模型复验同一位置:
body = 1,048,576 B  → 200 ✅  21.6 s  prompt_tokens = 349,578
body = 1,048,577 B  → 413 ❌   33 ms  Server: nginx/1.27.4
拿本项目自身的历史会话(1,624 条消息 / 7.24 MB,其中 toolResult 占 63.4%)模拟:
| 上下文规模 | 消息数 | 实际请求体 | 结果 |
|---|---|---|---|
| 100K tokens | 98 | 503,809 B(0.48 MiB) | ✅ 能发 |
| 200K tokens | 168 | 918,282 B(0.88 MiB) | ✅ 能发 |
| 300K tokens | 206 | 1,299,950 B(1.24 MiB) | ❌ 413 |
| 400K tokens | 238 | 1,891,432 B(1.80 MiB) | ❌ 413 |
| 630K tokens | 282 | 2,655,340 B(2.53 MiB) | ❌ 413 |
常见误判:「我上下文才 300 多 K,怎么就 413 了?」
因为那 300 多 K 是 token,不是 KB —— 300,000 × 4 ≈ 1.2 MB,早就超过 1 MiB 了。
自查公式(对代码/中英混排内容误差很小):
报错里的字节数 ÷ 4 ≈ 实际 token 数
1,048,576 ÷ 4 ≈ 262,000 tokens   ← 这条链路能装的上限
因为那次用的是最省字节的文本:随机 ASCII 每个字符基本等于一个 token,1 字节换 1 token,所以 974,025 字符只占 0.95 MiB。
它证明的是「模型窗口至少 745,080 tokens」(验证码放最开头、问题放最后,模型准确答出), 不代表日常能塞 74 万 token —— 同样 74 万 token 换成代码内容约需 2.9 MiB,早就 413 了。
| 尝试 | 结果 | 原因 |
|---|---|---|
| 直接发 2.38 MiB | 413 |
nginx 拒绝 |
Transfer-Encoding: chunked(分块发送,实测 2.38 MiB + 正确路径) |
413 |
nginx 累加所有分块的总量,分块不等于减小体积 |
Content-Encoding: gzip(2.38 MiB → 2.5 KB) |
nginx 放行,但返回 400 There was an error parsing the body |
OpenWebUI 不解压请求体(nginx 的 gunzip 只作用于响应) |
换其他路由(/api/v1/files/、/api/v1/retrieval/process、/api/v1/auths/signin) |
全部 413 |
限制是 server 级,不是单个 location |
| HTTP/2(客户端启用 h2) | 413,且服务端协商回 HTTP/1.1 |
该站点未启用 h2;即便启用,client_max_body_size 与协议版本无关 |
网页端提示「文件大小不应超过 2 MB」(来自 OpenWebUI 的 RAG_FILE_MAX_SIZE),但实测:
| 文件大小 | 结果 |
|---|---|
| 1,048,000 B(0.99 MiB) | 通过 nginx,到达应用层(422:我表单字段没填对) |
| 1,048,576 B(1.00 MiB) | 413 nginx |
| 1.5 MB / 2.0 MB / 2.1 MB | 413 nginx |
所以界面承诺的 2 MB 永远达不到,实际能传约 1.00 MB(1,048,576 减去 multipart 头几百字节)。 这是一处配置不一致:应用层说 2 MB、传输层只给 1 MB。
网页版对话同理 —— 浏览器把完整历史打包进 POST /api/chat/completions 的 body,聊得足够久也会 413,只是人打字慢,很难撞到。
| 场景 | 做法 |
|---|---|
| 用 pi / Claude Code / Codex 等 agent | 把模型的 contextWindow 设成 250000(别填 700000),pi 就会在 ~23 万 token 自动压缩,永远进不了死区 |
| 已经撞上 413 | /compact 立刻把历史压成摘要 |
| 需要读大文件 | 用 grep / sed -n '1,200p' 分片,不要 read 整个文件(toolResult 是最大的体积来源) |
| 需要长上下文任务 | 换用没有 1 MiB 限制的 provider(本项目支持多 provider 并存) |
| 想彻底解决 | 请管理员把 client_max_body_size 调大(例如 8m),并顺手与 RAG_FILE_MAX_SIZE 对齐 |
首次启动自动生成;用面板认证过的不用改。
| 字段 | 默认 | 说明 |
|---|---|---|
listen.host / port |
127.0.0.1:8787 |
只本机;改 0.0.0.0 才能局域网分发 |
upstream.base_url |
学校地址 | 支持子路径部署 |
upstream.token_file |
data/token |
按 mtime 热加载,换 token 不用重启 |
upstream.retries |
2 |
429/502-504/网络错误重试 |
upstream.transient_retries |
3 |
400/401/403 这类「上游抖动」的重试次数 |
upstream.disabled_models |
[] |
永不列出的模型(学校侧挂了的模型可以写进来) |
upstream.circuit_breaker_threshold / _seconds |
3 / 60 |
连续不可达 → 熔断冷却 |
client_api_key |
sk-whut-local |
主 key;置空且无子 key 时不校验 |
max_tokens_cap |
120000 |
输出上限钳制(实测 131072 通过,略留余量) |
strip_fields |
store,metadata,… |
上游不一定认识的字段 |
keep_alive_ms |
8000 |
流式静默心跳,0=关闭 |
default_model |
deepseek-v4-flash |
请求没带 model 的兜底 |
| 模型窗口 | deepseek-v4-flash:700K 上下文 / 120K 输出 |
来自 实测报告:高熵文本下输入 745,080 tokens 仍能召回开头内容,输出 131072 通过 |
| ⚠️ 请求体硬限制 | 1 MiB | 每次请求都要把「系统提示 + 全部历史 + 工具定义」整包发出去,字节超 1 MiB 会被学校反代 413。中文约 20 万 tokens、英文散文也约 20 万(只有高熵代码类文本能接近 78 万),所以长会话实际可用输入 ≈ 20 万 tokens,而不是 700K |
repo_url |
本仓库地址 | 面板右上「GitHub」图标跳转的地址 |
token_refresh.email |
学号 | 面板认证后自动写入 |
token_refresh.refresh_before_days |
2 |
剩余小于该值就续期 |
token_refresh.check_interval_minutes |
60 |
后台检查间隔 |
usage.db_path |
data/usage.db |
用量库(含 key 与认证事件) |
usage.retention_days |
180 |
自动清理旧记录 |
access.default_rpm_limit |
120 |
新 key 默认每分钟上限(0=不限) |
access.default_daily_token_limit |
0 |
新 key 默认每日 token 配额(0=不限) |
环境变量覆盖:WHUT_BASE_URL、WHUT_TOKEN、WHUT_TOKEN_FILE、WHUT_EMAIL、WHUT_PORT、WHUT_HOST、WHUT_CLIENT_KEY、WHUT_MAX_TOKENS_CAP、WHUT_DATA_DIR。
wut-deepseek2api/
├── app/                      后端(FastAPI)
│   ├── core/                 配置 · SQLite · 路径 · 日志
│   ├── providers/            上游抽象 + OpenWebUI 实现
│   ├── modules/
│   │   ├── proxy/            /v1/chat/completions · 参数修正 · SSE 透传
│   │   ├── anthropic/        /v1/messages(Claude Code)
│   │   ├── responses/        /v1/responses(Codex CLI)
│   │   ├── auth/             学号登录 · 自动续期 · 事件历史
│   │   ├── usage/            用量聚合 · CSV
│   │   ├── access/           多 key · 配额 · 限速 · 模板
│   │   └── system/           健康检查 · 静态资源
│   └── main.py               组装 + 挂模块
├── web/                      面板(Vue 3 + Vite)
│   ├── src/                  源码
│   ├── public/               架构动画图 · 截图
│   └── dist/                 构建产物(已提交,运行不需要 Node)
├── scripts/modeltest/        模型实测(bench · suites · report)+ results/
├── docs/                     说明文档(Docker 部署手册、模型与协议实测报告)
├── data/                     运行时数据(token、用量库,已忽略)
├── Dockerfile · docker-compose.yml · .env.example
├── requirements.txt · config.example.json
└── LICENSE
- 这是一个个人学习项目,用于学习 HTTP 代理、流式传输与协议转换。
- 与武汉理工大学官方无关,不代表学校立场,也未获得学校授权。
- 使用时请遵守学校的网络与信息系统管理规定,仅限个人本地使用,不要对外提供服务。
MIT License · 详见 LICENSE